Strands Decider 2B 是一個小型、開源的決策模型,專為快速實驗、本地開發和創新而優化。
今年稍早,我們宣布了 strands-labs,一個可以實際操作最先進的代理式 AI 方法的平台。今天,我們很高興推出 Strands Decider 2B:一個專為快速實驗、本地開發和創新而優化的小型決策模型。
Strands decider 屬於一類新型的決策模型或系統一模型,自 TypeSafe AI 本月稍早推出 Jev 後,這類模型便備受關注。與能生成任意輸出的 LLM 不同,決策模型旨在從一組選項中進行選擇(例如:「字串『打開燈』與咖啡機有關嗎?是或否。」、「『sihamba ngokushesha』是什麼語言?英語、祖魯語或荷蘭語。」),並分配簡單的數值分數(例如:「字串『這是我讀過最好的文件』是正面情緒嗎?介於 0 和 1 之間。」)。
為了換取這種靈活性的降低,決策模型在給定規模下速度更快、能力更強,始終能從選定的選項中產生答案,並且能以非常低的延遲運行。
反過來說,這種方法(一次性並行生成所有輸出)使其在解決複雜問題方面比推理模型差得多,而且由於缺乏生成文本的能力,因此不適合編碼、聊天機器人、文件摘要和其他常見的 LLM 任務。
此外,決策模型為每個決策提供高品質的可靠性分數(即「我對這個是/否答案的正確性有多確定?」),這在邊緣 LLM 推理 API 中是無法獲得的。它們還能高效地針對同一提示提出多個問題。這些特性的組合使它們非常適合驅動我們看到許多開發者使用 Strands Harness SDK 和最近推出的 Strands harness 建構的代理式工作流程。我們預計這類模型將在未來幾週、幾個月和幾年內引領代理式 AI 的許多有趣創新。
Strands Decider 2B 是我們對這項創新的第一個貢獻。它是一個 20 億參數的模型,適合在本地 CPU 或 GPU 上運行,能在數十毫秒內返回有意義問題的答案。其準確度和校準度與我們所知的同類其他模型相比具有競爭力。我們已在 GitHub 上開源 strands-decider-2b,權重則在 Hugging Face 上提供,包括我們用於建構模型的全部訓練資料和腳本,使其成為您自行展開創新之旅的絕佳起點。
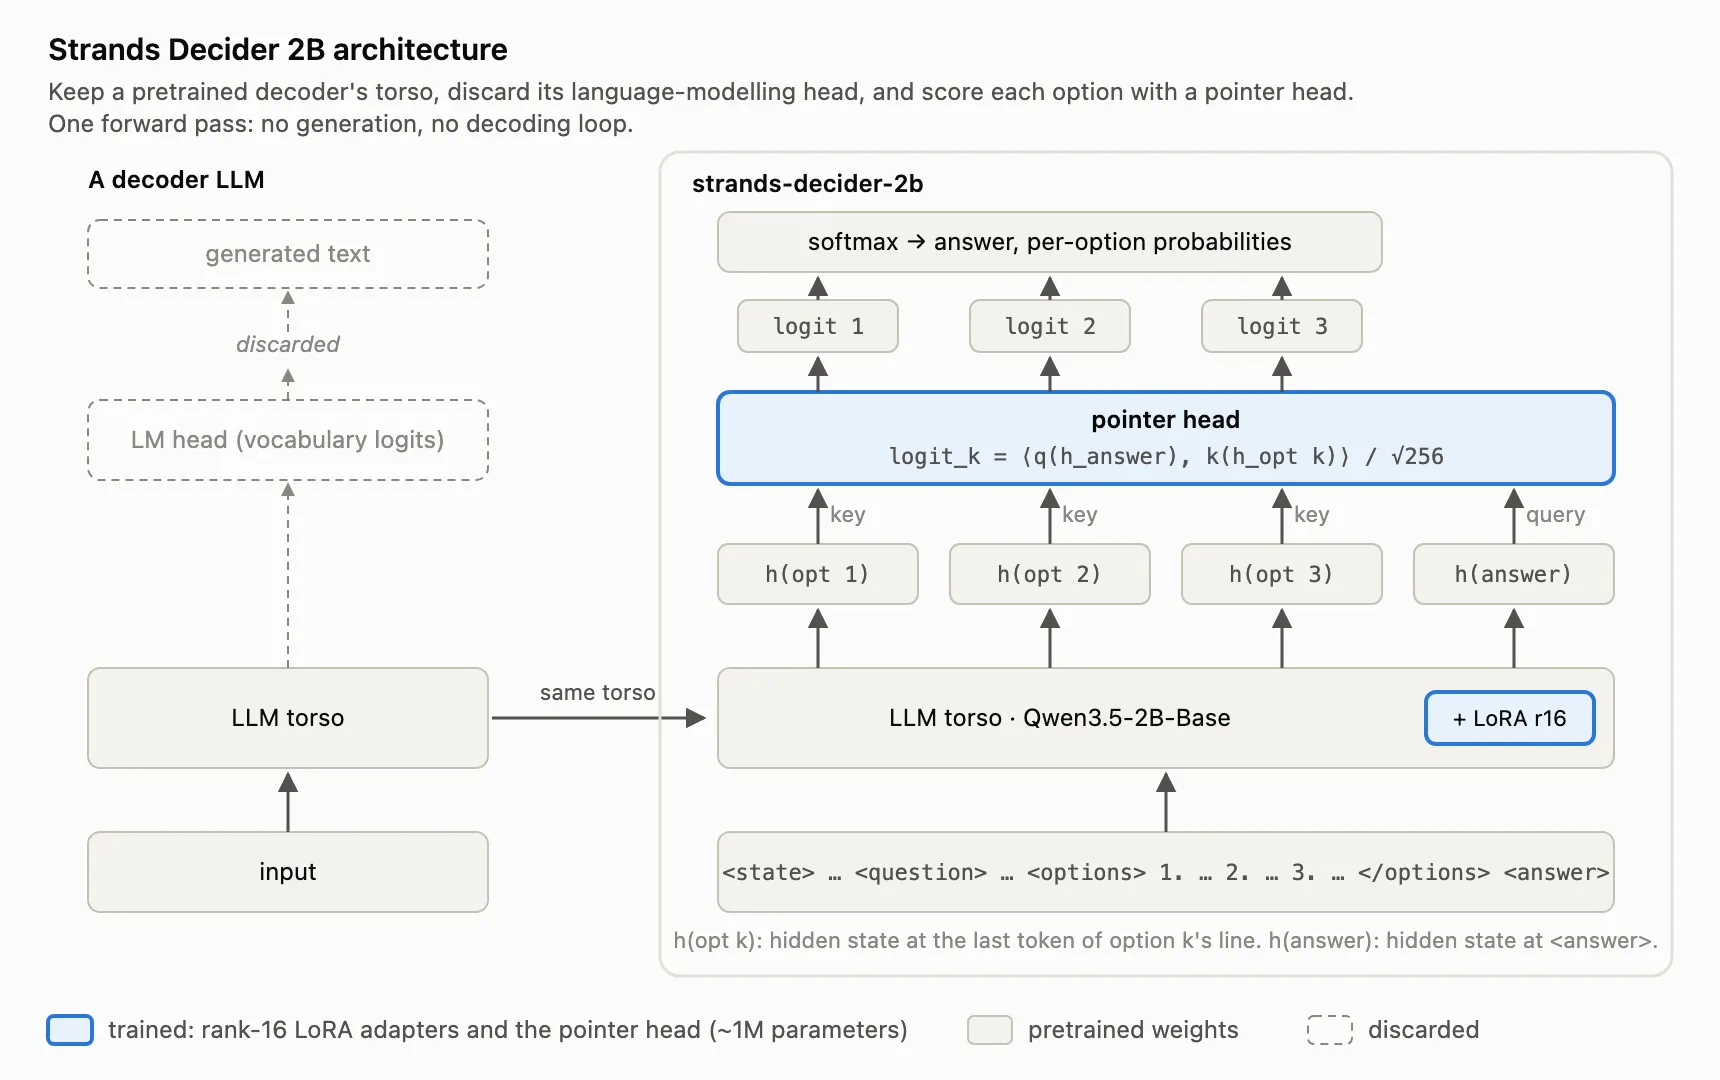
核心理念是我們採用預先訓練的 LLM 軀幹(Qwen3.5-2B),並移除語言模型頭部,剝奪其生成文本的能力。LM 頭部被一個指標頭部取代,該頭部為軀幹為每個選項提供的答案評分。它透過將每個選項位置的隱藏狀態與 <answer> 位置的隱藏狀態進行評分來實現。這個頭部相當小,總參數僅略超過一百萬。軀幹則使用 rank-16 LoRA 適配器進行微調。
圖 1:Strands Decider 2B 架構。
當您瀏覽儲存庫時,會發現這是該架構的第二個主要迭代。第一個類似,但使用了我們發現性能顯著較差的槽頭部。事實上,我們今天發布的模型是 v19,內部經過了大量迭代。我們在每個版本中更改的所有內容都包含在儲存庫中,您可以跟蹤我們所做的工作。
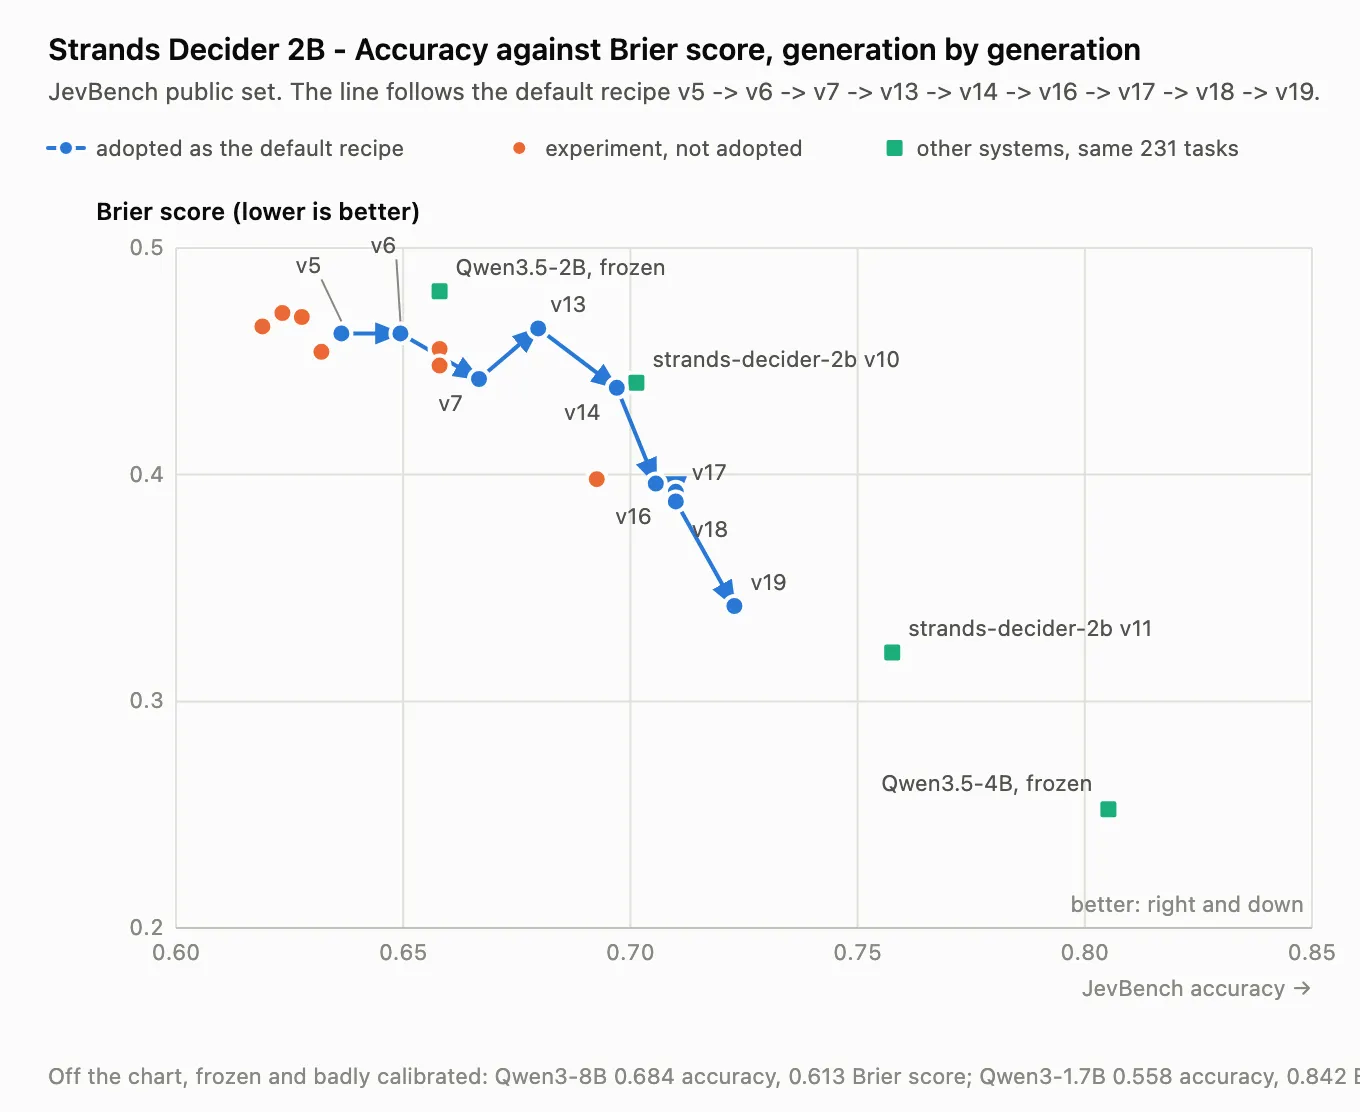
對於這類模型,我們關注三個性能目標:準確性(它回答問題的程度)、校準性(其信心分數的可靠程度)和延遲(它做出決策的速度)。我們一直將前兩者一起衡量:在 JevBench 的公開集上的準確性,以及在同一集上使用 Brier 分數進行校準。我們發現 strands-decider-2b 在準確性和校準性方面表現良好(在 2B 類別中排名第 3,排除剛超過 2B 的模型後排名第 1)。隨著我們架構的演進,我們的分數不斷提高,並且我們對未來改進有許多想法。我們希望社群能本著 Strands labs 的精神,加入我們,貢獻您自己的新想法。
圖 2:訓練軌跡中的準確性和校準性(Brier 分數)。隨著架構在連續版本中的演進,這兩項指標在 JevBench 的公開集上都有所改善。
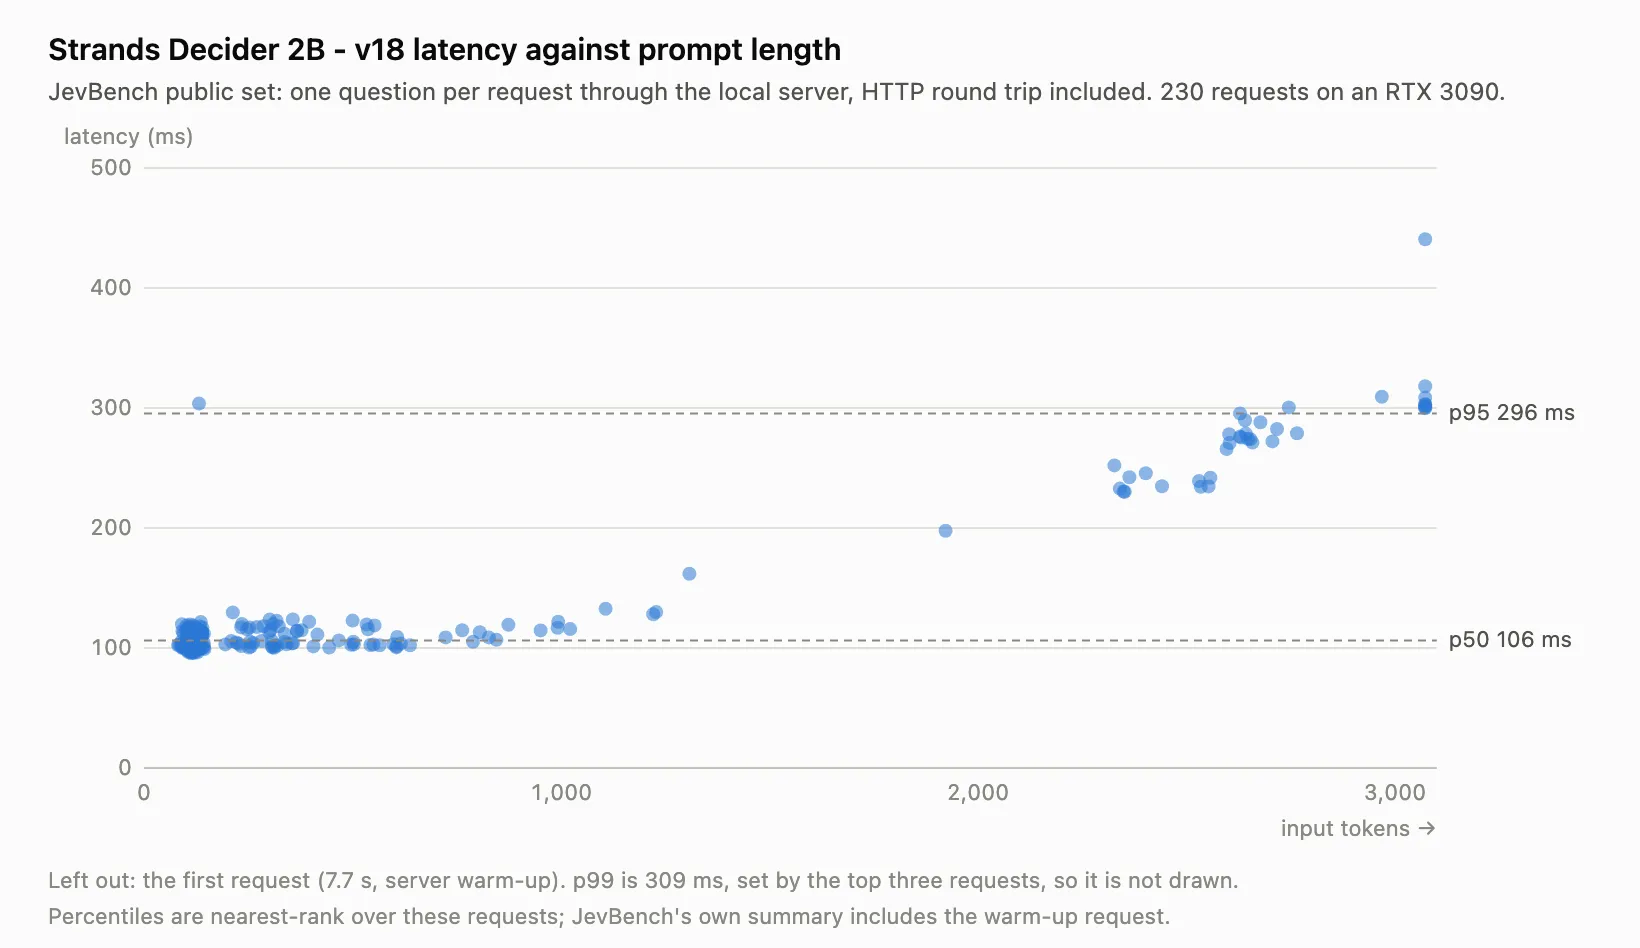
在延遲方面,strands-decider-2b 可以在常見硬體上以中位數約 115 毫秒的速度做出本地決策。決策所需時間取決於任務大小,隨著任務大小的增加,大約呈線性增加。此處圖表中的結果是在本地 Nvidia RTX3090 上測得的,但在 M3 MacBook 上的性能差異不大,小型任務的中位數延遲約為 153 毫秒。與準確性和校準性一樣,我們有很多想法可以進一步改進,特別是在降低地板延遲方面。
圖 3:決策延遲與任務大小(以 token 為單位)的關係,在本地 Nvidia RTX 3090 上使用模型的 v18 版本測量。延遲隨任務大小近似線性增加。
我們選擇將 Strands decider 作為一個小型模型提供,原因有二。一是我們希望鼓勵實驗。您可以使用,甚至訓練 strands-decider-2b 在您已有的硬體上進行。這使得嘗試新事物變得容易、快速且風險低。二是 20 億總參數似乎是一個甜蜜點:足夠小以便實驗,足夠大以便完成有意義的工作。例如,Strands decider 在 JevBench 的簡單任務上能 100% 正確地完成,而這類問題與我們看到人們使用代理解決的一些較簡單問題非常吻合。
無論您想做什麼!更認真地說,我們看到這類模型在模型路由、工具選擇、評估、守門員、記憶體、上下文管理和策略分類方面取得了早期成功。我們也看到了圍繞建構混合代理的令人興奮的創新,使用 LLM 來做出最困難的決策,並使用決策模型來做出較容易的常規決策,從而降低成本和延遲。我們看到結合決策模型與固定工作流程語言來建構另一種混合工作流程的實驗。人們也使用這類模型來玩遊戲、自動化任務、導航迷宮等等。這個領域的創新速度令人驚嘆。
最容易入門的地方是透過 strands-decider CLI:
您可以要求模型根據某些狀態和問題進行選擇:
在此輸出中,我們可以看到模型預測計費作為機率分數最高的答案。
儲存庫還包括在 Strands agent 中使用 strands-decider-2b 的範例,位於 examples/strands/ 下。該代理本身在本地運行,連接到也在本地運行的 Strands decider,然後使用 Amazon Bedrock 的預設 LLM。
這是一個刻意設計的小型場景。該代理擁有(必須有的)演示天氣獲取工具,以及一個系統提示,使其故意表現得積極主動,因此當使用者詢問「天氣如何?」而沒有說明地點時,代理會猜測一個城市並調用工具。然而,在該調用運行之前,strands-decider-2b 會讀取對話和建議的工具調用,並回答兩個是/否問題:這些參數值是否基於使用者實際說過的任何內容(劇透:沒有!),以及現在調用此工具是否太早。幾行 Python 代碼將預測轉化為決策,代理會返回詢問您指的是哪個城市,而不是自信地報告某個沒人提到的地方的天氣。
這裡的模式是 Strands 的干預系統。我們使用 InterventionHandler 的 before_tool_call 方法,將其傳遞給 Agent(interventions=[...]) ,它會在任何工具執行之前運行。它返回一個類型化的動作: Proceed(繼續)、Deny(拒絕)、Confirm(停止並詢問人類)或 Guide(將模型交還並提供反饋),而不是直接阻止調用。這個現有的處理器是一個 Python 類別,Strands 對其內部內容沒有任何意見,因此無論您是調用我們的決策模型、Cedar 策略還是其他代理,相同的結構都適用。(在模型調用周圍和整個調用周圍都有等效的掛鉤。)這個範例是說明而不是推薦,因此問題、閾值和策略都是手動選擇的。重點是,這種廉價的決策可以放在 LLM 調用永遠無法進入的路徑上。
Strands 團隊正在開發用於決策模型整合的函式庫,請密切關注儲存庫的更新。
您可以立即下載、使用或基於 strands-decider-2b 進行建構。所有資料都可用,以及您開始所需的一切。您可以從 GitHub 獲取代碼,從 Hugging Face 獲取最新快照。現在就去實驗吧!